Як запустити Dolphin LLM: локальне налаштування проти хостованого API
Оновлено
Ця сторінка показує, як запустити модель типу Dolphin або на вашому власному комп'ютері, або через хостований ендпоінт, і як прийняти рішення між ними. Коротка версія: локально безкоштовно за токен, але потрібна пам'ять і терпіння; хостовано потрібен лише ключ.
Ключові моменти
- Локальні сервери потребують достатньо оперативної пам'яті або VRAM для квантованого файлу та кешу контексту.
- Ollama — найшвидший старт; llama.cpp дає більше контролю над квантуванням та прапорцями.
- Обидва інструменти надають сервер у стилі OpenAI, тому один і той самий код клієнта може вказувати як на локальний, так і на хмарний сервер.
- Хостований ендпоінт коштує $0.15 за 1M вхідних та $0.50 за 1M вихідних токенів і налаштовується за хвилини.
Спочатку визначтеся: яке обладнання у вас є?
Пам'ять вирішує все. Мовна модель — це величезний набір чисел, і весь цей набір має знаходитися в швидкій пам'яті під час генерації. Квантування зменшує ці числа. 4-бітна квантована модель займає приблизно пів байта на параметр, тому модель на 8B параметрів займає близько 5 ГБ, а на 70B — близько 40 ГБ. Сприймайте ці цифри як орієнтовні, оскільки точний розмір залежить від формату квантування.
Поруч із вагами вам потрібне місце для кешу контексту. Він зростає з довжиною промпту, тому довга історія рольової гри або великий документ коштують більше пам’яті, ніж коротке запитання. Плануйте кілька додаткових гігабайтів при помірному контексті, більше, якщо ви прагнете до довгих промптів.
- Ноутбук з 8 ГБ пам’яті без GPU: тільки невеликі моделі, повільний вивід.
- 16 до 32 ГБ Mac на чипі Apple Silicon: середні моделі добре працюють, оскільки CPU та GPU спільно використовують пам'ять.
- Один споживач GPU з 12–24 ГБ VRAM: середні моделі з хорошою швидкістю.
- Щось більше: кількома GPU або орендованим сервером.
Метод 1: Ollama за кілька команд
Ollama — найкоротший шлях. Він завантажує квантовану модель, запускає фоновий сервер і надає чат-промпт. Встановіть його з офіційного сайту для вашої операційної системи, а потім перевірте, які теги Dolphin Ollama model library зараз перелічує, оскільки назви та розміри змінюються між релізами.
# replace <tag> with a Dolphin tag from the Ollama library
ollama pull <tag>
ollama run <tag>
Перша команда завантажує файл, що може зайняти багато часу на повільному з'єднанні. Друга команда відкриває інтерактивний чат у терміналі. Ollama також надає HTTP API на вашому комп'ютері, включаючи маршрут у стилі OpenAI під /v1, щоб інші програми могли його використовувати.
Якщо генерація дуже повільна, ймовірно, модель не вмістилася у VRAM і частина її працює на CPU. Оберіть менший тег або квантизацію з меншою бітністю.
Метод 2: llama.cpp для більшого контролю
llama.cpp — це C++ рушій, на якому побудовано багато інших інструментів. Ви завантажуєте файл GGUF моделі, а потім запускаєте її сервер. Це вимагає більше кроків, ніж Ollama, але дозволяє встановити довжину контексту, кількість шарів, які розміщуються на GPU, та бажану квантизацію.
# after building llama.cpp and downloading a GGUF file
llama-server -m ./model.gguf -c 8192 -ngl 99 --port 8080
Тут -c встановлює довжину контексту, -ngl визначає, скільки шарів буде перенесено на GPU, і --port вибирає порт. Перевірте README проекту на наявність прапорців у вашій версії, оскільки вони змінюються. Більший -c використовує більше пам'яті, тому збільшуйте його лише тоді, коли це необхідно.
Для графічного використання фронтенди, такі як Open WebUI, можуть звертатися до будь-якого з серверів. Наша примітка щодо Кінцеві точки API Open WebUI показує, як додати кастомний ендпоінт.
Виклик локального сервера з коду
Обидва інструменти підтримують формат чату OpenAI, тому ви пишете клієнт один раз і змінюєте ціль лише двома налаштуваннями. Цей скрипт демонструє обидві цілі поруч. Локальна версія використовує порт, який Ollama використовує за замовчуванням; змініть його, якщо ви запустили llama.cpp на порту 8080.
from openai import OpenAI

TARGETS = {
    "local": {"base_url": "http://localhost:11434/v1", "key": "not-needed", "model": "your-local-tag"},
    "hosted": {"base_url": "https://dolphinllm.com/v1", "key": "YOUR_KEY", "model": "uncensored"},
}

t = TARGETS["hosted"]
client = OpenAI(base_url=t["base_url"], api_key=t["key"])

resp = client.chat.completions.create(
    model=t["model"],
    messages=[{"role": "user", "content": "Summarize what a GGUF file is."}],
)
print(resp.choices[0].message.content)
Локальні сервери зазвичай ігнорують ключ, але SDK вимагає непорожній рядок. Ім'я моделі для локального сервера — це будь-який тег або псевдонім, який ви завантажили, тоді як ідентифікатор хостованої моделі завжди uncensored.
Метод 3: пропустіть налаштування та використовуйте хостовану кінцеву точку
Якщо математика апаратного забезпечення виглядає погано, або ви хочете однакової поведінки на кожному комп'ютері, хостований ендпоінт є простішим варіантом. Цей сервіс надає одну модель з відкритим кодом, яку обслуговує незалежний провайдер і яка налаштована відповідати без відмов у вмісті для законного дорослого використання. Це не офіційний API жодного постачальника моделей, і він не дозволяє обирати інші моделі. Ви отримуєте стабільний URL, ключ та оплату за токени.
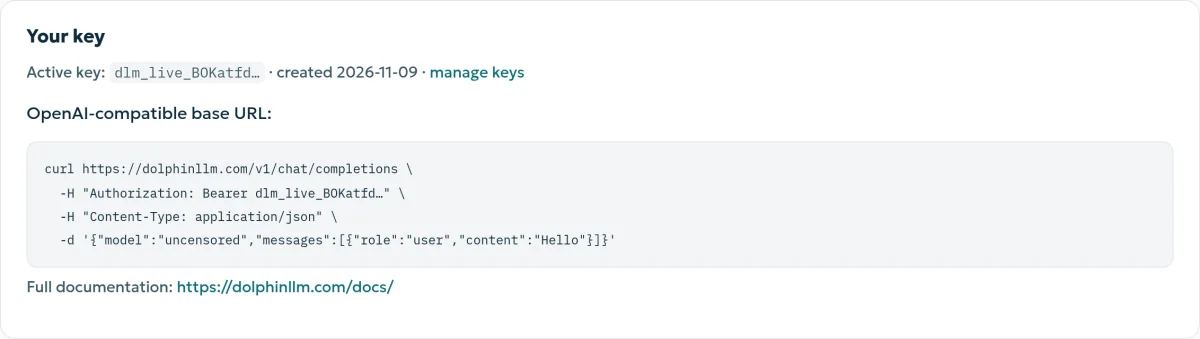
Кроки короткі. Зареєструватися з електронною поштою та паролем та створіть свій ключ в обліковому записі. $0.50 пробного кредиту додається при першому відкритті облікового запису: без картки, дійсний протягом 7 днів, один на особу. Потім запустіть наведений вище Python-скрипт із хостованою адресою. Якщо ви віддаєте перевагу cURL:
curl https://dolphinllm.com/v1/chat/completions \
  -H "Authorization: Bearer YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"uncensored","messages":[{"role":"user","content":"Hello"}],"stream":false}'
Вікно контексту становить 262 144 токенів, приблизно 490 сторінок тексту, що більше, ніж більшість ноутбуків можуть комфортно тримати в кеші. Запити не використовуються для навчання.
Порівняння витрат та зусиль
Локальне середовище здається безкоштовним, але це не так. Ви платите за апаратне забезпечення, електроенергію та свій час. Хостинг коштує грошей за кожен запит, але ціни невеликі. За ціною $0.15 за 1M вхідних токенів та $0.50 за 1M вихідних токенів, один діалоговий крок з 3,000 вхідними токенами та 700 вихідними токенами коштує:
- Вхідні: 3,000 × $0.15 / 1,000,000 = $0.00045
- Вивід: 700 × $0.50 / 1,000,000 = $0.00035
- Загальна вартість: $0.0008 за хід, тобто $0.80 за 1,000 ходів
Навіть активний користувач, який надсилає 5 000 таких обмінів за місяць, витратить близько $4. GPU, який коштує сотні доларів, потребуватиме років експлуатації, щоб окупити витрати на такий обсяг. Ситуація змінюється, коли у вас є безперервний високий обсяг, потрібна конкретна дообучена модель або дані не можна виводити за межі вашого пристрою. Наш хостований API проти оренди GPU порівняння працює через числа.
Повні деталі цін, включаючи бонуси за поповнення +5%, +10% та +15%, наведені на сторінка з цінами, та documentation покриття лімітів і параметрів.
Просте правило вибору
Запускайте локально, якщо хочете експериментувати з багатьма дообученими моделями, працювати офлайн або зберігати всі запити на своєму диску. Використовуйте хостований ендпоінт, якщо ви створюєте щось, чим користуватимуться інші, якщо ваше залізо обмежене або якщо вам потрібен контекст на 262 144 токенів без керування пам’яттю. Багато розробників використовують обидва варіанти: локальну модель для приватних експериментів і хостований ендпоінт для всього, що має бути доступним. Оскільки код клієнта однаковий, перехід займає лише одну рядок.
Питання та відповіді
Скільки оперативної пам'яті потрібно для запуску моделі Dolphin?
Орієнтовно, для 4-бітної квантованої моделі потрібно приблизно пів байта на параметр плюс пам'ять для кешу контексту. Модель на 8B параметрів вміщується в 5–8 ГБ, а на 70B — приблизно 40 ГБ і більше.
Чи можу я запустити його без GPU?
Так, на CPU з достатньою кількістю RAM, але вивід буде повільним для будь-яких моделей, крім невеликих. Mac на Apple Silicon працюють краще, оскільки пам’ять є спільною.
Чи використовується однаковий клієнтський код для локального та хмарного середовищ?
Більшою мірою так. Обидва приймають запити у стилі чату OpenAI, тому змінюється лише базовий URL, ключ та назва моделі.
Чи є безкоштовний спосіб спробувати хостований варіант?
Нові користувачі отримують $0.50 пробного кредиту при першому відкритті акаунту. Він не вимагає картки та дійсний протягом 7 днів.
Більше посібників
 API Dolphin LLM: локально, орендований GPU або хмарнийТри способи отримати API для моделі Dolphin без цензури: запустити локально, обслуговувати на орендованому GPU або викликати хостований ендпоінт, сумісний з OpenAI. Порівняння зусиль та витрат.
 Безкоштовний LLM API для розробників: Пробний період проти оплати за використанняЩо дає безкоштовний рівень API LLM і де він закінчується. Пробний період без картки на $0.50, потім центи за виклик: що це купує, як витратити з розумом і що перевірити перед підпискою.
 Хостований API проти оренди GPU для моделі середнього розміруСкільки коштує запустити середню відкриту модель на орендованій GPU (RunPod, Vast.ai, Lambda) порівняно з оплатою за токен на Dolphin LLM, з розрахунком точки беззбитковості.
